19× mais dados, a mesma memória: streams no Node.js
Você já se perguntou como grandes empresas com milhões de registros geram relatórios o tempo todo sem que o sistema trave ou fique indisponível? Imagine uma fintech que precisa exibir relatórios num dashboard e, muitas vezes, enviá-los depois por e-mail ou para algum bucket.
Então, como o uso de streams pode resolver isso sem comprometer o sistema? Streams são coleções de dados, assim como arrays e objetos. A diferença é que nem sempre estão disponíveis de uma vez e não precisam estar inteiramente alocados em memória (esse é o ponto-chave), eles chegam em chunks (pedaços), o que facilita trabalhar com grandes volumes de dados.
O benefício é manter o uso de memória constante: como os dados não são carregados todos de uma vez, você não sobrecarrega o servidor nem trava o event-loop do JavaScript.
Como disse Linus Torvalds, "talk is cheap, show me the code", então vamos ao código.
async function* readRows(
  filter: FilterQuery<Transaction>,
): AsyncGenerator<ReportRow> {
  const cursor = TransactionModel.find(filter)
    .read("secondary")
    .lean()
    .cursor();
  try {
    for await (const doc of cursor) {
      yield mapRow(doc);
    }
  } finally {
    await cursor.close();
  }
}
O uso de workers com async jobs foi fundamental para o sistema. O worker é responsável por buscar os dados no MongoDB, que, por sinal, está num replica set, lendo dos secundários em vez do primário. Todos esses fatores contribuem para lidar de forma eficiente com grande volume de dados.
Para controlar o fluxo de dados vindos do banco, uso dois métodos: .lean() e .cursor(). O primeiro evita a "hidratação" do Document do MongoDB num objeto JavaScript, o segundo traz os resultados em batches (lotes), que eu consumo como uma generator function.
export async function generate(input: ReportInput, jobId: string) {
  const fmt = FORMATS[input.format];
  const body = new PassThrough();
  const upload = uploadStream(reportKey(jobId, fmt.ext), body, fmt.contentType);

  await fmt.write(readRows(buildTransactionFilter(input)), body);
  await upload;

  return { downloadUrl: `/reports/${jobId}/download` };
}
Por fim, a função generate é quem amarra tudo. Ela não lê nem formata nada por conta própria, a função dela é conectar as coisas e deixar os dados fluírem.
Um detalhe bem importante é o PassThrough. No código eu tenho 2 coisas, o serializador que é responsável por transformar as linhas retornadas para algum formato de relatório (csv, pdf, etc), então ele precisa escrever e o upload para o bucket precisa ler algo (veja a imagem abaixo). O PassThrough é o stream que é os dois ao mesmo tempo. Pensa nele como um cano: o serializador escreve em uma ponta e o upload lê na outra.
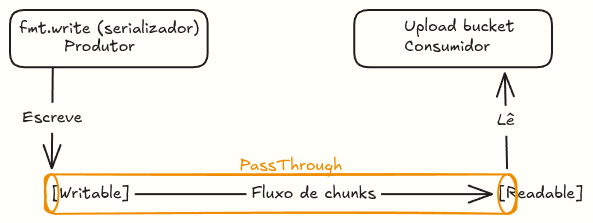
Com todas essas estratégias, é possível gerar relatórios com ~1 milhão de linhas mantendo a memória praticamente constante. Criei um script para medir o pico de RAM, veja os resultados abaixo.
Medi o pico de memória do processo gerando o mesmo relatório em três tamanhos. De 30 para 365 dias, o arquivo gerado pulou de 8,9 MB para 169 MB (19× mais dados). O pico de RAM? Subiu até um teto de ~436 MB e estacionou ali. O caso mais claro: indo de 90 para 365 dias, mais que quadruplicando os dados (de 215 mil para quase 1 milhão de linhas), a memória não saiu do lugar: 437 MB contra 436 MB. Se eu tivesse carregado tudo em memória antes de escrever, esse relatório sozinho consumiria vários gigabytes, com streams, ele cabe no mesmo teto de qualquer relatório menor. O tempo cresce com o volume, como esperado! A memória, não.
| Janela    |  Linhas   | Arquivo gerado  | Pico de RAM  |
| 30 dias   |  51 mil   | 8,9 MB          | 324 MB       |
| 90 dias   |  215 mil  | 37,7 MB         | 437 MB       |
| 365 dias  |  969 mil  | 169,6 MB        | 436 MB       |